In breve
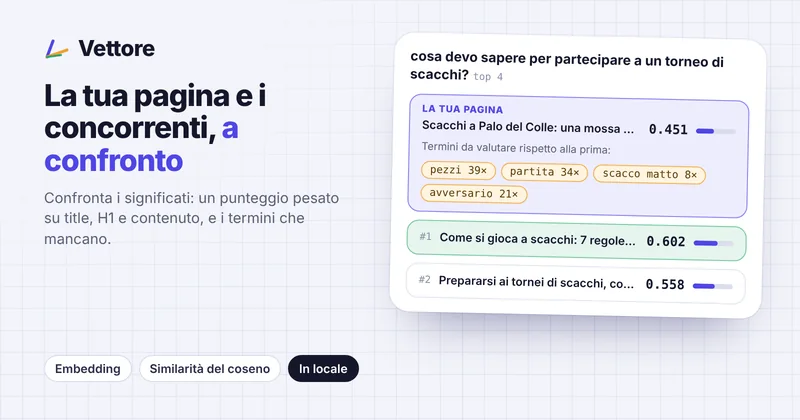
La pertinenza semantica di una pagina si misura trasformando keyword e testi in embedding e confrontandoli con la similarità del coseno. Vettore, il tool che ho sviluppato, lo fa in locale su title, H1 e contenuto, combina i punteggi (30% title, 20% H1, 50% contenuto) e mostra i termini che i concorrenti usano e la tua pagina no.
| Cosa fa | Classifica fino a 50 pagine per fino a 20 keyword, per significato e non solo per parole esatte |
| Provider | Locale e gratuito (modello multilingue) oppure OpenAI |
| Estrazione | Mozilla Readability, la stessa tecnologia della «modalità lettura» di Firefox |
| Punteggio | 30% title + 20% H1 + 50% contenuto |
| Stack | Node.js, Express, transformers.js, frontend HTML/JS senza build |
| Nasce da | Un flusso con Google Sheets, Screaming Frog e Apps Script, ora tutto in un unico strumento |
Che cos’è un embedding?
Un embedding è una lista di numeri che rappresenta il significato di un testo. Testi con significati simili producono vettori vicini, anche se usano parole diverse: «auto usata» e «macchina di seconda mano» finiscono vicini, mentre il conteggio delle parole chiave li considererebbe diversi.
Che cos’è la similarità del coseno?
È la misura dell’angolo tra due vettori: vale 1 quando puntano nella stessa direzione e scende man mano che i significati si allontanano. Non dipende dalla lunghezza del testo, solo dalla direzione, e per questo è la misura più usata per confrontare embedding.
Come funziona Vettore, passo per passo?
- Input: fino a 20 keyword, la tua pagina (facoltativa), fino a 50 pagine da confrontare e quante mostrarne per keyword.
- Download ed estrazione: da ogni pagina si estraggono title, H1 e contenuto principale; se una URL non si scarica, viene segnalata e si va avanti.
- Embedding: keyword, title, H1 e blocchi di contenuto diventano vettori, in un’unica chiamata.
- Punteggi: per ogni coppia keyword–pagina si calcola la similarità con title, H1 e contenuto (per il contenuto vale il blocco migliore).
- Punteggio complessivo: 30% title + 20% H1 + 50% contenuto.
- Termini mancanti: si confronta la frequenza di parole e coppie di parole tra la tua pagina e il miglior concorrente.
Modello locale o API: quale scegliere?
| Locale (gratuito) | OpenAI | |
|---|---|---|
| Modello | paraphrase-multilingual-MiniLM-L12-v2 | text-embedding-3-small o large |
| Costo | Zero, dopo un download di circa 110 MB | A consumo, molto basso |
| Lunghezza del testo | Circa 128 token: contenuto diviso in blocchi da ~70 parole, massimo 6 | Fino a 8.192 token |
| Dati | Restano sul computer | Inviati al servizio |
| Quando usarlo | Analisi frequenti, contenuti riservati | Pagine lunghe, massima precisione |
Come si leggono i punteggi?
- In modo relativo: quale pagina è più vicina alla keyword rispetto alle altre, non come un voto assoluto.
- I valori raramente superano 0,7–0,8, anche per contenuti molto pertinenti.
- Il punteggio non è un fattore di ranking: indica dove il contenuto è debole rispetto a ciò che gli utenti trovano altrove.
Quali sono i limiti?
- Con il modello locale si analizzano al massimo le prime 400–500 parole del contenuto.
- L’analisi dei termini mancanti è lessicale: «scarpa» e «scarpe» contano come termini diversi.
- Paywall, protezioni anti-bot e pagine che mostrano il testo solo con JavaScript possono non essere leggibili.
Cosa può fare per un’azienda
L’analisi semantica aiuta a decidere dove intervenire sui contenuti, con dati invece di impressioni:
- audit dei contenuti rispetto ai concorrenti che si posizionano meglio;
- scelta della pagina giusta per una keyword, evitando la cannibalizzazione;
- brief editoriali con i concetti da coprire;
- verifica prima e dopo una riscrittura.
Se stai valutando qualcosa di simile per la tua organizzazione, raccontami il tuo caso: partiamo dalle domande a cui deve rispondere, non dalla tecnologia.
Cosa ho imparato
- Il significato si può misurare, ma il numero va letto in relazione agli altri, non da solo.
- Con un modello locale piccolo bisogna rispettare il limite di token: dividere il testo in blocchi e tenere il migliore è un compromesso semplice ed efficace.
- Title e H1 sono pochi caratteri, ma sono segnali forti: per questo hanno un peso separato.
Domande frequenti
Che cos’è la similarità del coseno nella SEO?
È una misura, da 0 a 1 nei casi pratici, di quanto due testi sono vicini per significato una volta trasformati in embedding. Nella SEO si usa per confrontare una pagina con una keyword o con le pagine concorrenti.
La similarità semantica è un fattore di ranking di Google?
No, non direttamente: è uno strumento di analisi per capire se un contenuto copre davvero l’argomento della ricerca, rispetto a ciò che già si posiziona.
Serve una chiave API per usare gli embedding?
No: un modello multilingue locale come paraphrase-multilingual-MiniLM-L12-v2 funziona sul proprio computer senza costi, con il limite di circa 128 token per testo.