In breve
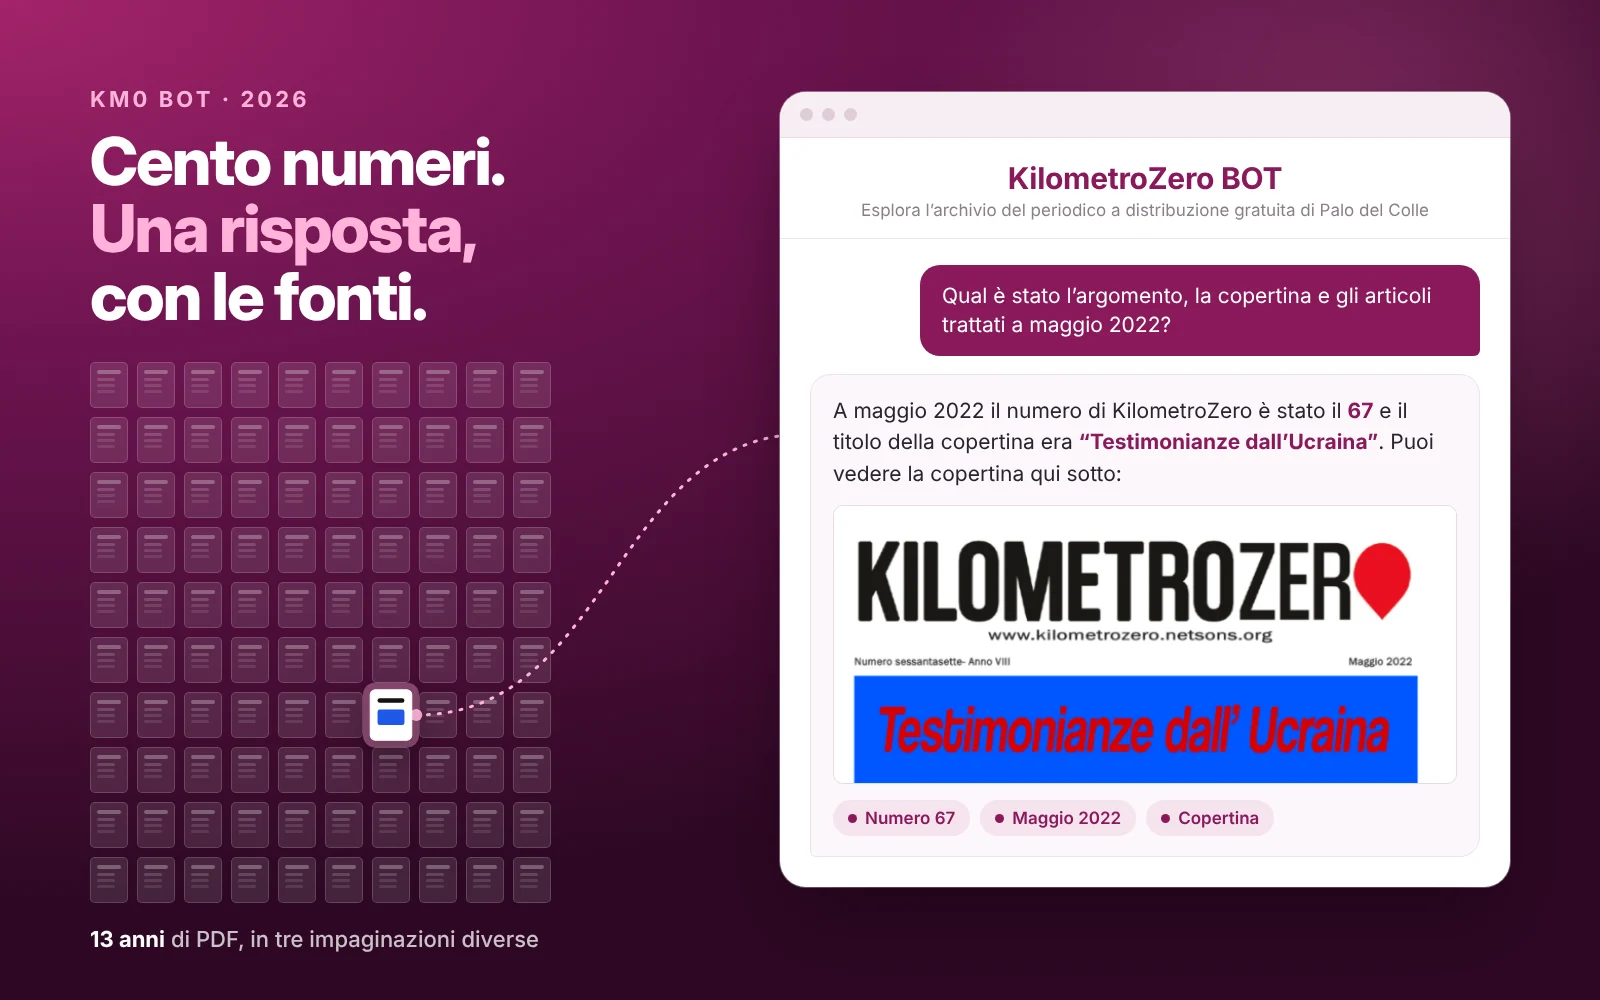
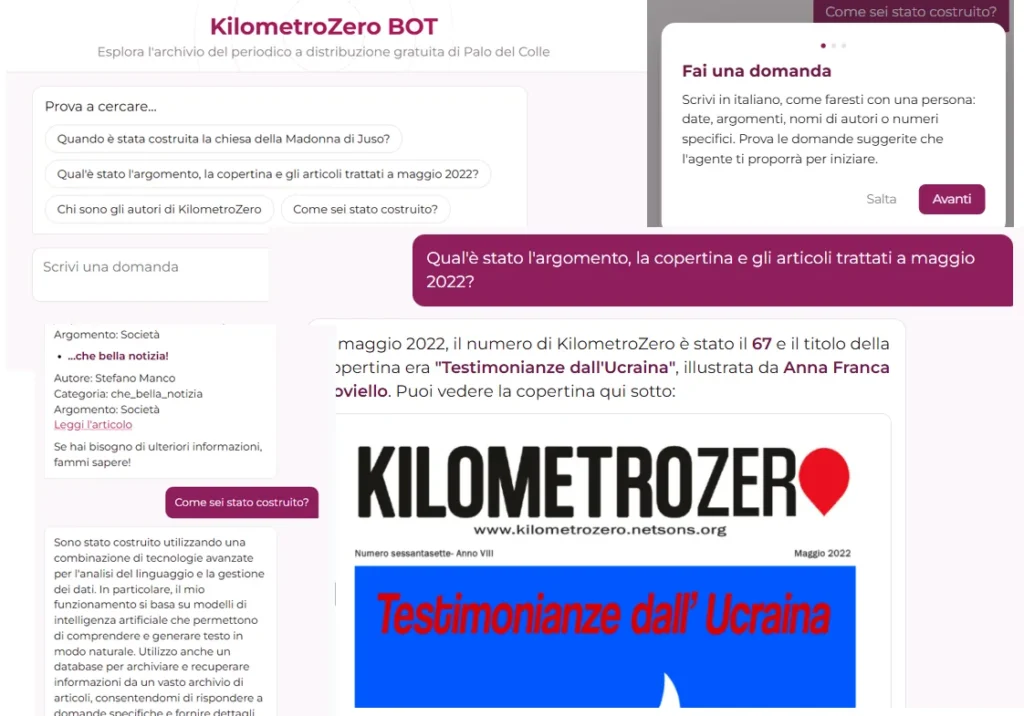
KM0 Bot è un assistente basato su RAG (Retrieval-Augmented Generation) che risponde in italiano su tredici anni di archivio del periodico KilometroZero di Palo del Colle. Unisce la ricerca semantica (embedding e vector store) a strumenti deterministici per conteggi e date, e ogni affermazione cita numero, pagina e autore della fonte.
| Contesto | KilometroZero, periodico gratuito di Palo del Colle (BA) fatto da una redazione di volontari, dal 2013 |
| Problema | Cento numeri in PDF, in tre impaginazioni diverse: un archivio consultabile solo sfogliandolo |
| Soluzione | Assistente conversazionale in italiano con fonti citate e link al PDF o alla pagina web |
| Stack | Python, pdfplumber, OpenAI text-embedding-3-small, Chroma, gpt-4o-mini, FastAPI, frontend HTML/JS senza librerie |
| Hosting | Backend su Render, frontend statico su Netsons |
| Costo per domanda | Circa 0,001–0,003 $ (embedding della domanda + risposta con 6 estratti di contesto) |
| Stato | Online: prova KM0 Bot |
KilometroZero racconta dal 2013 la vita sociale, politica e associativa del paese. Ne faccio parte dal 2020 e, per l’uscita del numero 100, ho voluto fare un regalo alla comunità: rendere l’intero archivio interrogabile in linguaggio naturale. Il suo scopo è restituire memoria a un paese: chi ha scritto di cosa, quando, e come se ne parlava allora.
Che cos’è un sistema RAG, in breve?
Un sistema RAG non chiede al modello linguistico di «ricordare» le informazioni: prima cerca nei documenti i passaggi più pertinenti alla domanda, poi li passa al modello come contesto e gli chiede di rispondere solo su quella base. È l’approccio più usato per costruire assistenti su archivi, manuali e knowledge base aziendali, perché riduce le risposte inventate e permette di mostrare le fonti.
Perché un archivio di PDF è difficile da interrogare?
Il problema non è il modello, ma il testo. In tredici anni il giornale ha cambiato impaginazione tre volte, e un’estrazione «ingenua» del testo da un PDF a colonne mescola articoli diversi. L’estrazione è stata calibrata su 10 numeri reali che coprono le tre epoche grafiche.
| Epoca | Numeri | Cosa cambia per l’estrazione |
|---|---|---|
| 1 | 0–24 | Palette arancione/verde, nessuna pagina web per i singoli articoli |
| 2 | 26–49 | Palette gialla, argomento del numero evidenziato in grassetto |
| 3 | 50–99 | Palette rossa, argomento evidenziato a colori, rubriche fisse a pagina 3 |
Come funziona KM0 Bot, passo per passo?
- Download dei PDF dall’archivio del giornale, con un manifest e l’hash di ogni file.
- Estrazione layout-aware: per ogni parola si leggono posizione e dimensione del carattere, si individuano le colonne e si ricostruisce l’ordine di lettura.
- Segmentazione in articoli: i titoli si riconoscono dal corpo del carattere (oltre 1,35 volte il testo), poi si risolvono titolo, autore e rubrica di ogni articolo.
- Embedding e vector store: ogni articolo diventa un vettore (OpenAI text-embedding-3-small) salvato in Chroma, con numero, pagina, mese, anno e categoria come metadati.
- Recupero: la ricerca semantica prende i 6 estratti più vicini (da un gruppo tre volte più ampio), con un piccolo peso per i numeri più recenti e il contesto degli ultimi due messaggi.
- Risposta: il modello (gpt-4o-mini) risponde solo sul contesto e cita ogni fatto nel formato «KMZ n.X, p.Y».
- Fonti: il box delle fonti mostra solo le citazioni presenti davvero nella risposta, con link al PDF o alla pagina web dell’articolo.
Perché la ricerca semantica non basta?
Domande come «quanti articoli ha scritto…» o «cosa è uscito a maggio 2022» non si risolvono con la somiglianza tra testi: servono numeri esatti. Per questo l’agente ha a disposizione strumenti deterministici che interrogano i metadati.
| Strumento | A cosa serve |
|---|---|
search_archive | Ripetere la ricerca semantica con una domanda riformulata, invece di arrendersi al primo tentativo |
count_by_author, count_by_category, count_by_issue | Conteggi esatti di articoli distinti (non di frammenti di testo) |
list_articles | Elenchi filtrati per anno, mese o intervallo di mesi |
get_cover_image | Mostrare la copertina di un numero, o dire chiaramente che non è disponibile |
Come si evita che l’AI inventi le risposte?
- Il prompt chiede di rispondere solo sul contesto recuperato e di dichiarare quando l’archivio non contiene la risposta.
- Ogni fatto deve avere una citazione nel formato «KMZ n.X, p.Y».
- Le fonti mostrate all’utente sono calcolate dal codice, non scritte dal modello; se la risposta dice «non ho trovato», il box delle fonti sparisce.
- Le biografie dei 13 redattori sono indicizzate come documenti veri, così il bot non «deduce» chi sono le persone dagli articoli firmati.
Come è stato valutato?
Con un set di domande scritte a mano, divise per tipo, e un report che confronta le fonti attese con quelle usate. La valutazione serve soprattutto a trovare gli errori: le domande su periodi e mesi «saltati» dalla pubblicazione sono state le più difficili, ed è da lì che sono nati il filtro per mese e anno e il peso per i numeri recenti.
| Tipo di domanda | Esempio | Cosa verifica |
|---|---|---|
| Fatti | Quando è uscito il primo numero? | Recupero di un’informazione puntuale |
| Persone | Chi ha condotto un’intervista? | Autori e rubriche risolti correttamente |
| Luoghi ed eventi | Cosa racconta un numero su un luogo? | Sintesi fedele di un articolo |
| Multi-documento | Come è cambiato il tema di copertina in sei mesi? | Combinare più numeri |
| Calcoli | Quanti editoriali ha scritto un autore? | Uso degli strumenti di conteggio |
| Periodi | È uscito un numero a gennaio 2026? | Date esatte, senza approssimare |
| Fuori archivio | Chi ha vinto le elezioni regionali? | Dire «non lo so» invece di inventare |
Sicurezza e costi
- Nessuna chiave API nel frontend: tutte le chiamate al modello passano dal backend.
- Domande limitate a 500 caratteri, 20 richieste al minuto per IP, CORS ristretto ai domini del giornale.
- Costo stimato: frazioni di centesimo per indicizzare un numero, 0,001–0,003 $ per domanda.
Cosa può fare per un’azienda
Lo stesso schema funziona su qualsiasi archivio documentale in cui le persone perdono tempo a cercare:
- manuali tecnici e schede prodotto, interrogabili dal customer service;
- procedure interne, policy e documentazione HR;
- archivi editoriali, cataloghi e listini;
- documentazione di progetto e verbali, con risposte che citano documento e pagina.
Se stai valutando qualcosa di simile per la tua organizzazione, raccontami il tuo caso: partiamo dalle domande a cui deve rispondere, non dalla tecnologia.
Cosa ho imparato
- La qualità di un sistema RAG si decide nell’estrazione dei testi, prima ancora che nel modello.
- Ricerca semantica e domande «contabili» hanno bisogno di strumenti diversi: conviene riconoscerle e trattarle separatamente.
- Mostrare le fonti, e solo quelle usate davvero, è la differenza tra una risposta plausibile e una risposta verificabile.
- Una valutazione onesta trova i limiti prima degli utenti.
Domande frequenti
Quanto costa un assistente RAG su un archivio di documenti?
Dipende dal volume, ma con modelli piccoli come text-embedding-3-small e gpt-4o-mini l’indicizzazione costa frazioni di centesimo per documento e ogni domanda circa 0,001–0,003 dollari. Il costo principale è la preparazione dei dati.
Funziona anche con PDF scansionati?
KM0 Bot lavora su PDF con testo selezionabile, quindi non usa l’OCR. Per documenti scansionati serve un passaggio di riconoscimento del testo prima dell’indicizzazione.
Come si evita che un chatbot aziendale inventi le risposte?
Limitando il modello al contesto recuperato, chiedendo una citazione per ogni fatto, calcolando le fonti con il codice e verificando il sistema con domande di cui si conosce la risposta, comprese quelle a cui deve dire «non lo so».
Si può usare un modello locale invece di un servizio cloud?
Sì: il provider degli embedding e il modello linguistico sono configurabili. Un modello multilingue locale come multilingual-e5-small è un’alternativa senza costi per chiamata.