In breve
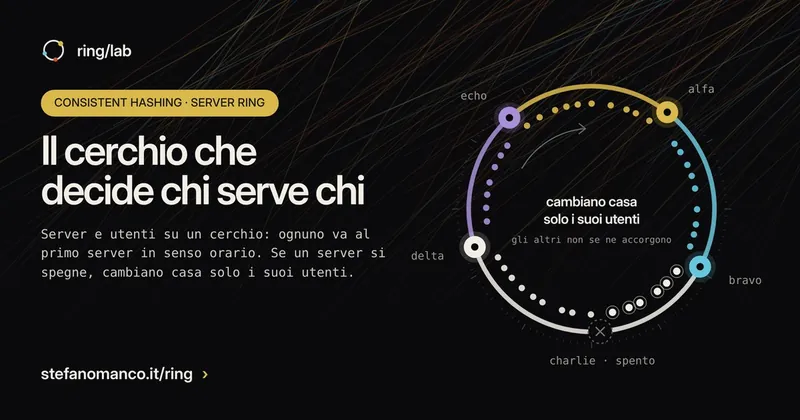
Il consistent hashing è una tecnica per distribuire utenti o dati tra molti server: server e chiavi stanno su un cerchio e ogni chiave va al primo server che incontra in senso orario. Quando un server si aggiunge o si spegne, si spostano solo le chiavi vicine a lui, non tutte: per questo lo usano database distribuiti, CDN e cache.
Ogni volta che apri una chat, aggiungi un prodotto al carrello o guardi un video, un sistema decide in una frazione di secondo quale server, tra centinaia, deve rispondere proprio a te. Visto che vengo dalla comunicazione e dal design, ho fatto quello che faccio sempre quando voglio capire davvero una cosa: l’ho trasformata in una cosa da toccare.
Perché non basta dividere gli utenti a turno o con il resto della divisione?
| Metodo | Come assegna | Cosa succede se cambia il numero di server |
|---|---|---|
| A turno (round robin) | Una richiesta per server, in ordine | Il lavoro è diviso bene, ma nessuno ricorda l’utente: carrello e sessione si perdono |
| Hash modulo N | hash(utente) mod N | Cambiando N cambia la casa di quasi tutti gli utenti |
| Consistent hashing | Primo server sul cerchio in senso orario | Si spostano solo gli utenti del server aggiunto o rimosso (in media 1/N) |
Come funziona il cerchio?
- Ogni server riceve una o più posizioni sul cerchio, calcolate con una funzione di hash.
- Anche ogni utente (o chiave) riceve una posizione.
- L’utente va al primo server che incontra girando in senso orario.
- Le posizioni dei server sono ordinate, quindi una ricerca binaria come
bisect_righttrova il server giusto senza fare tutto il giro.
Cosa succede quando un server si spegne?
Per ogni utente ci sono un server principale e un paio di riserve: i server successivi sul cerchio. Se il principale si spegne, cambiano casa solo i suoi utenti, che passano alla riserva; tutti gli altri non se ne accorgono.
A cosa servono cache e soglie di memoria?
- Cache: le risposte usate spesso si tengono in un «cassetto» con pochi posti; quando è pieno, esce quella usata meno di recente (politica LRU).
- Soglie di memoria: un server con poca memoria libera viene evitato, ma con un margine tra la soglia di uscita e quella di rientro (isteresi), così il sistema non cambia idea ogni secondo.
Chi usa il consistent hashing?
La tecnica è stata descritta nel 1997 da Karger e colleghi per distribuire le cache del web, ed è alla base di sistemi come Amazon Dynamo e Apache Cassandra, oltre che di molte CDN e cache distribuite.
Cosa può fare per un’azienda
Capire queste scelte aiuta a parlare con i fornitori tecnici e a decidere meglio quando un servizio deve crescere:
- siti e e-commerce che devono reggere picchi di traffico;
- cache e CDN per pagine e immagini più veloci;
- applicazioni che devono restare disponibili anche se un server si guasta.
Se stai valutando qualcosa di simile per la tua organizzazione, raccontami il tuo caso: partiamo dalle domande a cui deve rispondere, non dalla tecnologia.
Cosa ho imparato
- Dietro ogni servizio che «funziona e basta» ci sono scelte di equilibrio tra velocità, affidabilità e risorse.
- Spostare il minor numero possibile di utenti quando qualcosa cambia è una proprietà che vale oro.
- Capire queste scelte aiuta a parlarne meglio, anche con chi il codice non lo scrive.
Si può toccare tutto: aggiungere server, spegnerli, vedere chi cambia casa.
Domande frequenti
Che cos’è il consistent hashing in parole semplici?
È un modo di assegnare utenti o dati ai server disponendoli su un cerchio: ognuno va al primo server in senso orario, e quando i server cambiano si spostano solo pochi utenti.
Che differenza c’è tra consistent hashing e load balancing a turno?
Il bilanciamento a turno divide il lavoro ma non ricorda gli utenti; il consistent hashing manda sempre lo stesso utente allo stesso server, utile per sessioni e cache.
Perché si usano le repliche nel consistent hashing?
Per la disponibilità: se il server principale di una chiave si spegne, i successivi sul cerchio la servono al suo posto.