In breve
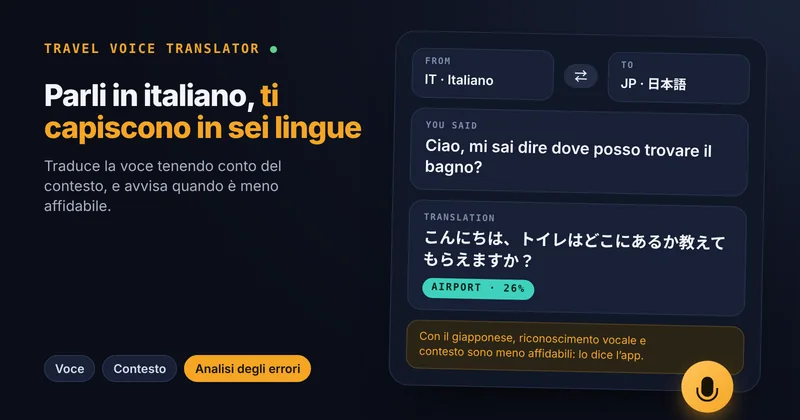
Per scegliere un modello di riconoscimento vocale o di traduzione non basta prendere il più noto: bisogna misurarlo sulle proprie frasi, con metriche come WER e CER per la trascrizione e BLEU e chrF++ per la traduzione, e pesare accuratezza, costo e latenza. Travel Voice Translator è lo studio pratico in cui ho applicato questo metodo.
| Cosa fa | Parli nella tua lingua: l’app trascrive, traduce e legge la risposta ad alta voce, in entrambe le direzioni |
| Lingue | Italiano, inglese, spagnolo, francese, tedesco, giapponese |
| In produzione | API OpenAI per trascrizione, traduzione e sintesi vocale; classificatore di contesto addestrato da zero |
| Nel banco di prova | Whisper (locale) contro API OpenAI per la voce, NLLB-200 (locale) contro OpenAI per la traduzione |
| Stack | FastAPI, scikit-learn, frontend HTML/CSS/JS mobile-first, Docker |
| Deploy | Render, piano gratuito, aggiornato a ogni push sul repository |
Non è (e non vuole essere) un prodotto commerciale: è uno studio sugli strumenti, per capire davvero come si valutano e si scelgono i modelli in un sistema reale.
Come funziona l’app?
- Il browser registra la voce (MediaRecorder API).
- Il backend la trascrive con un servizio di speech-to-text.
- La trascrizione viene tradotta nella lingua di destinazione.
- Un classificatore riconosce il contesto della frase e suggerisce frasi rapide pertinenti.
- La traduzione viene letta ad alta voce con la sintesi vocale; un tasto la ripete.
Se il microfono non è disponibile o il permesso è negato, l’app passa da sola all’inserimento del testo: stessa traduzione, stessa voce.
Quali metriche servono per valutare voce e traduzione?
| Metrica | Cosa misura | Come si legge |
|---|---|---|
| WER (Word Error Rate) | Parole sbagliate, mancanti o in più nella trascrizione | Più è basso, meglio è |
| CER (Character Error Rate) | Lo stesso, ma sui caratteri | Utile per lingue come il giapponese, senza spazi tra le parole |
| BLEU | Sovrapposizione di sequenze di parole con una traduzione di riferimento | Più è alto, meglio è; severo con i sinonimi |
| chrF++ | Sovrapposizione di caratteri e parole | Più robusto di BLEU per lingue ricche di forme flesse |
Il banco di prova confronta modelli locali open source, Whisper e NLLB-200, con le API di OpenAI, in condizioni diverse (audio pulito, rumore, parlato veloce e lento) e su dataset pubblici come Common Voice e FLORES-200. Il punto non è scegliere il modello più popolare, ma il compromesso giusto tra accuratezza, costo e latenza per un’app che deve rispondere in pochi secondi.
Come si riconosce il contesto di una frase?
Con un classificatore addestrato da zero, TF-IDF più regressione logistica, che assegna la frase a uno di nove ambiti di viaggio (hotel, ristorante, taxi, aeroporto, emergenza…). È l’unico modello del progetto davvero addestrato: gli altri sono usati in inferenza.
| Metrica | Valore |
|---|---|
| Accuratezza al primo tentativo (top-1) | 46% |
| Accuratezza considerando le prime due ipotesi (top-2) | 69% |
| Macro F1 | 0,46 |
| Riferimento casuale (9 classi) | 11% |
| Dati e metodo | 180 esempi, validazione incrociata a 5 fold |
Non è un numero da vantarsi, ma è reale. Per questo l’interfaccia usa le prime due ipotesi invece di fidarsi ciecamente della prima, e avvisa quando il risultato è meno affidabile. L’analisi degli errori indica come primo passo l’ampliamento dei dati, prima di provare modelli più complessi.
Perché la latenza conta quanto l’accuratezza?
In una conversazione con un tassista o alla reception di un hotel, una traduzione perfetta che arriva dopo dieci secondi è inutile. Ogni risposta dell’API riporta i tempi di trascrizione, traduzione e classificazione, e l’app mostra il totale: è una misura continua del compromesso, non un benchmark fatto una volta sola.
E la privacy?
- Il backend non salva audio, trascrizioni o traduzioni: ogni richiesta è gestita in memoria e scartata.
- La chiave del servizio di AI resta sul server, mai nel codice del browser.
- La voce lascia il dispositivo solo per la clip appena registrata, non in modo continuo.
Cosa può fare per un’azienda
Il metodo, misurare prima di scegliere, vale per qualsiasi progetto con voce o traduzione automatica:
- assistenza clienti multilingue e centralini;
- reception e servizi turistici;
- trascrizione di riunioni, interviste o chiamate;
- localizzazione di contenuti, con una verifica della qualità per lingua.
Se stai valutando qualcosa di simile per la tua organizzazione, raccontami il tuo caso: partiamo dalle domande a cui deve rispondere, non dalla tecnologia.
Cosa ho imparato
- Le metriche vanno scelte prima dei modelli: WER e CER per la voce, BLEU e chrF++ per la traduzione dicono cose diverse.
- In un’app conversazionale la latenza pesa quanto l’accuratezza.
- Un modello modesto, misurato bene, si può usare con giudizio: l’interfaccia deve tenere conto dei suoi limiti.
Domande frequenti
Che differenza c’è tra WER e CER?
Il WER conta gli errori sulle parole, il CER sui caratteri. Per lingue senza spazi tra le parole, come il giapponese, il CER è più indicativo.
È meglio Whisper in locale o un’API di trascrizione?
Dipende da volume, privacy e latenza: un modello locale non ha costi per chiamata e tiene i dati in casa, un’API non richiede hardware dedicato. La scelta va fatta misurando WER e tempi sulle proprie registrazioni.
Quanti dati servono per addestrare un classificatore di testi?
Con 180 esempi su nove classi si ottiene un risultato modesto ma utile; aumentare gli esempi per classe è di solito il miglioramento più efficace, prima di cambiare modello.