In breve
Per evitare che un LLM inventi dati in un documento generato, i numeri vanno calcolati dal codice e passati al modello già pronti; al modello resta la scrittura, con una gerarchia delle fonti nel prompt e una verifica automatica di ogni citazione. Con questo metodo una pipeline trasforma i file PGN di un torneo di scacchi in una pubblicazione PDF commentata: 336 citazioni verificate, 0 errori.
| Input | File PGN ufficiali (mosse, giocatori, risultati) |
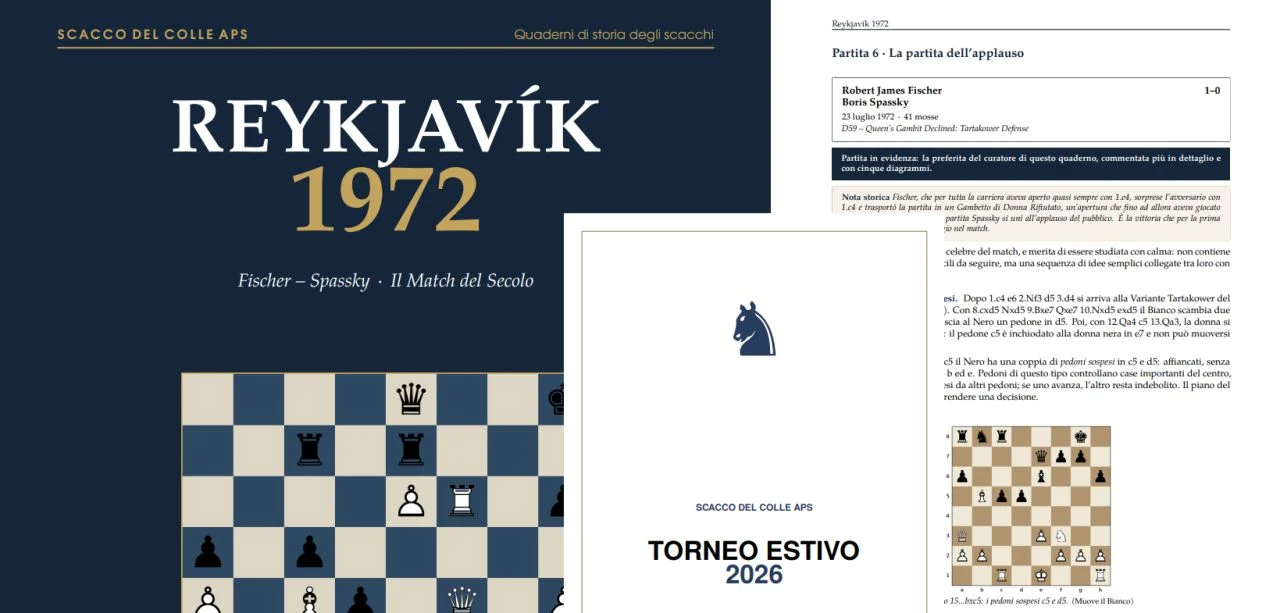
| Output | Pubblicazione PDF con classifica, risultati per turno, diagrammi e commento delle partite |
| Primo caso reale | Torneo Estivo 2026 di Scacco del Colle: 10 giocatori, 2 gironi, 30 partite, 27 pagine |
| Verifica di riuso | Match Fischer–Spassky, Reykjavík 1972: 21 partite, 39 pagine |
| Impaginazione | LaTeX, deterministica |
| Validazione | 336 mosse citate nel commento verificate sulla partita: 0 errori |
Che cos’è il PGN?
Il PGN (Portable Game Notation) è il formato standard con cui si registrano le partite di scacchi: intestazioni con giocatori, evento, data e risultato, e la sequenza delle mosse in notazione algebrica. È un dato strutturato e verificabile, quindi la fonte di verità ideale per un testo generato.
Chi fa cosa tra codice e intelligenza artificiale?
| Compito | Chi lo fa | Perché |
|---|---|---|
| Lettura del PGN e ricostruzione di ogni posizione | Codice (parser e motore che rigioca le mosse) | Deve essere esatto |
| Classifiche, spareggi fino allo scontro diretto, statistiche | Codice | Un errore di calcolo sarebbe un errore di contenuto |
| Diagrammi delle posizioni chiave | Codice | Generati dalle mosse reali, non disegnati |
| Sintesi, spiegazione e commento delle partite | LLM | È dove il modello è davvero utile |
| Verifica delle mosse citate nel commento | Script di controllo | Trova le varianti «creative» del modello |
| Copertina | Generativa, con ricerca di immagini a licenza libera e fallback grafico | Diversa per ogni pubblicazione |
| Impaginazione finale | LaTeX | Tipografia deterministica e ripetibile |
Come si scrive un prompt che non inventa?
Le istruzioni del progetto sono una specifica, non un desiderio. Contengono:
- una gerarchia delle fonti: PGN, poi materiale didattico, poi conoscenza generale;
- la distinzione esplicita tra dato («il Bianco gioca 23.Td1»), interpretazione («la torre aumenta la pressione sul pedone isolato») e valutazione del motore;
- una regola base: nel dubbio, non inventare.
Come si verifica un testo generato?
Uno script estrae ogni mossa citata nel commento e controlla che esista davvero nella partita o nelle sue annotazioni. Il risultato finale: 336 citazioni verificate, 0 errori, dopo aver eliminato qualche variante inventata dal modello.
Quando i dati si contraddicono, come una partita con il Nero in vantaggio decisivo registrata come vittoria del Bianco, l’anomalia viene segnalata nel testo, non corretta a intuito: decidere quale dato è giusto spetta all’arbitro, non al modello.
La pipeline è riutilizzabile?
Per verificarlo l’ho applicata a un classico: il match Fischer–Spassky di Reykjavík 1972, 21 partite commentate in 39 pagine. Stesso codice, stesse regole: cambia solo il PGN di partenza.
Cosa può fare per un’azienda
Lo stesso schema, dati calcolati dal codice e testo scritto dal modello, si applica a molti report aziendali:
- report periodici di vendita o di marketing con commento automatico;
- schede prodotto generate da dati tecnici strutturati;
- sintesi di dashboard per la direzione;
- documentazione che deve restare coerente con un database.
Se stai valutando qualcosa di simile per la tua organizzazione, raccontami il tuo caso: partiamo dalle domande a cui deve rispondere, non dalla tecnologia.
Cosa ho imparato
- Un LLM resta affidabile quando i dati gli arrivano già calcolati: il modello spiega, il codice conta.
- Una gerarchia delle fonti scritta nel prompt riduce le invenzioni più di qualsiasi raccomandazione generica.
- La verifica automatica delle citazioni è economica e trova errori che a occhio sfuggono.
- Le anomalie nei dati vanno dichiarate, non «aggiustate».
Domande frequenti
Come si evitano le allucinazioni nei report generati con l’AI?
Calcolando i numeri con il codice e passandoli al modello già pronti, dando una gerarchia delle fonti nel prompt e verificando automaticamente ogni dato citato nel testo prima della pubblicazione.
Perché usare LaTeX per l’impaginazione?
Perché è deterministico: lo stesso contenuto produce sempre lo stesso documento, con una tipografia di qualità e senza interventi manuali.
Si può applicare a dati diversi dagli scacchi?
Sì: qualsiasi dato strutturato e verificabile, come vendite, risultati di test o dati di prodotto, può fare da fonte di verità per un testo generato.
Fonti e riferimenti
Lo stesso principio, fonti prima di tutto, guida anche KM0 Bot.